
13 september 2026
Pick a Flick #1 – Een eigen filmrecommender bouwen
Ik heb een nieuw project.
Pick a Flick.
Het begon met een vrij simpel probleem: we hebben thuis Netflix, Disney+ en Prime Video en toch kost het soms twintig minuten om een film uit te kiezen.
Niet omdat er te weinig keuze is.
Maar omdat ik niks kan met de aanbevelingen van een Netflix of Disney. Als ik 3 keer een thriller heb gekeken. Krijg ik de komende weken alleen thrillers aangeboden. Terwijl mijn smaak veel breder is.
Ik mis een beetje de videotheek.
Daar liep je met z'n tweeën langs de bakken, trok een hoes eruit en zei: deze dan?
Dus dacht ik:
Zou ik dat zelf kunnen bouwen?
Pick a Flick
Het idee is niet om een betere IMDb of Letterboxd te bouwen.
Ik wil juist zo min mogelijk films laten zien.
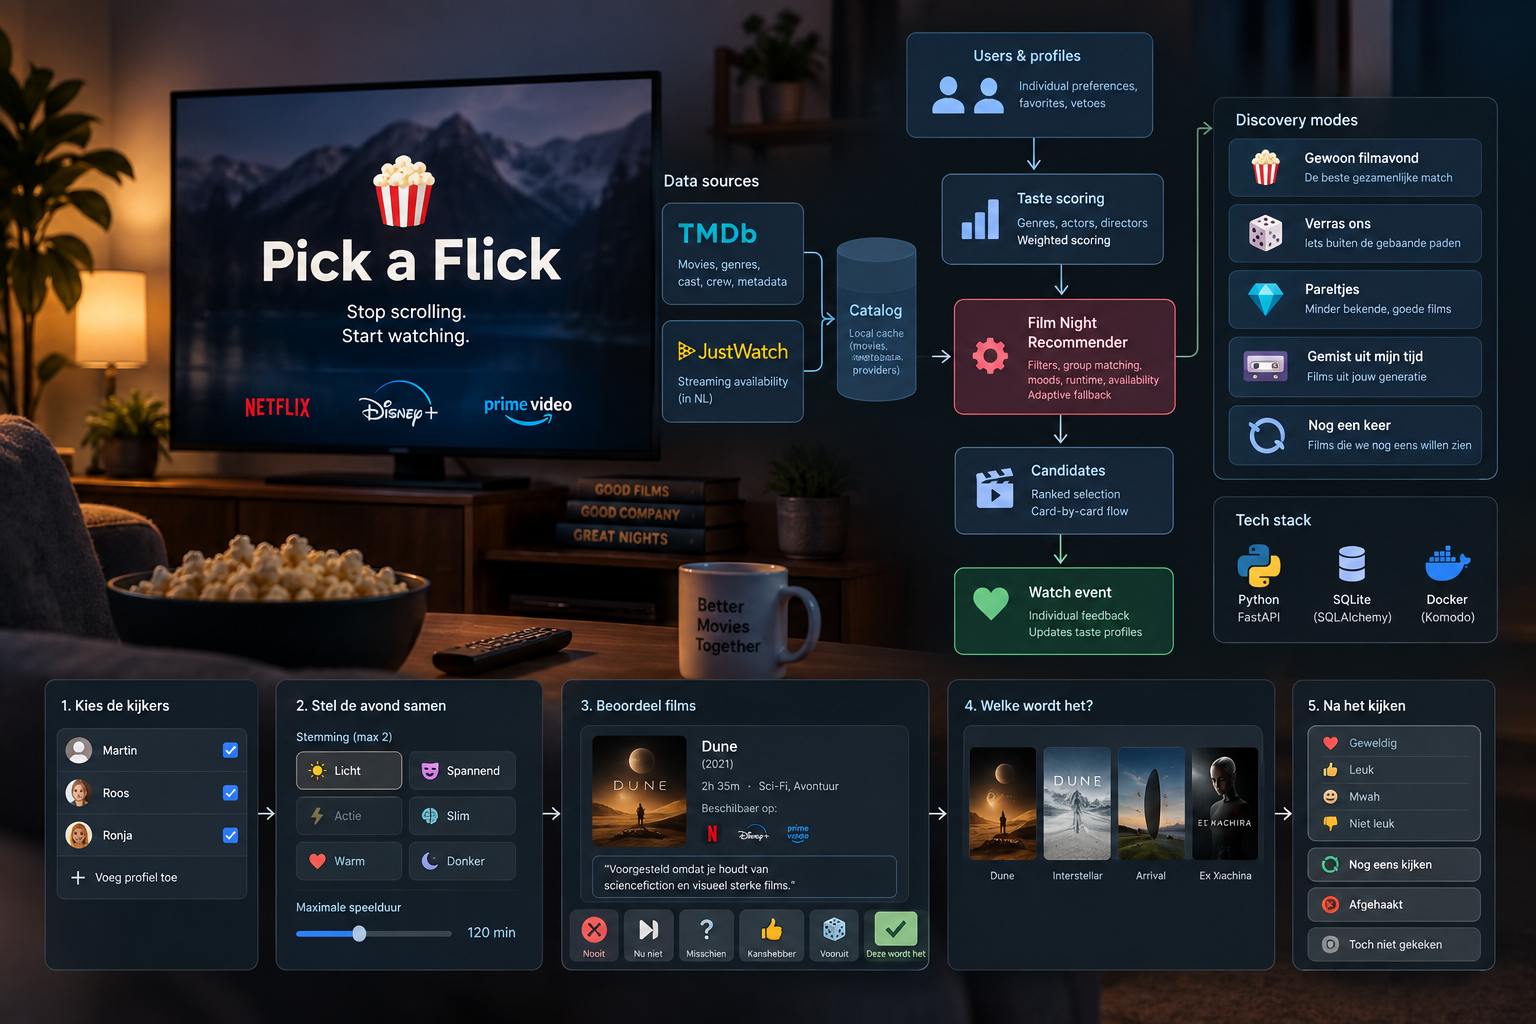
Pick a Flick moet antwoord geven op één concrete vraag:
We zitten vanavond met deze mensen op de bank. Welke film zullen we kijken?
Daarvoor moet de applicatie drie dingen weten:
-
Wie kijkt er mee?
-
Wat vinden die mensen ongeveer leuk?
-
Welke films kunnen we daadwerkelijk kijken?
En daarna moet hij vooral keuzes durven maken.
De stack
De eerste versie draait inmiddels op mijn homelab.
De stack is bewust vrij simpel:
Browser
   ↓
FastAPI
   ↓
Jinja templates
   ↓
SQLAlchemy
   ↓
SQLite
De applicatie draait in Docker en wordt via Komodo gedeployed.
Voor filmgegevens gebruik ik TMDb. Daar haal ik onder andere titels, posters, genres, acteurs, regisseurs en speelduur vandaan.
Via de watch-providergegevens kan Pick a Flick ook controleren of een film in Nederland daadwerkelijk beschikbaar is op een streamingdienst die wij hebben.
De beschikbaarheidsinformatie wordt lokaal gecachet. Ik wil niet bij iedere klik opnieuw allerlei externe API-calls doen.
Voorlopig is het dus één vrij klassieke Python-applicatie.
Eerst een smaakprofiel
Iedereen thuis maakt een eigen profiel. Voorlopig zonde rwachtwoord ofzo.
Bij het aanmaken daarvan laat Pick a Flick ongeveer twintig bekende films zien.
Per film kun je aangeven:
❤️ geweldig
👍 leuk
😐 mwah
👎 niet leuk
?  niet gezien
Daarna voeg je nog een paar absolute favorieten toe.
Uit die beoordelingen bouwt Pick a Flick een eenvoudig smaakprofiel op.
Daarbij kijk ik niet alleen naar genres.
Als iemand meerdere films van Quentin Tarantino geweldig vindt, is Quentin Tarantino waarschijnlijk een interessanter signaal dan alleen crime of drama.
Hetzelfde geldt voor acteurs.
Daarom sla ik bij films onder andere dit soort informatie lokaal op:
Movie
 ├── Genres
 ├── Actors
 ├── Director
 ├── Runtime
 ├── Language
 └── Availability
Daartegenover staat per profiel:
ProfileMovieRating
 ├── Seen
 ├── Rating
 ├── Favorite
 ├── Rewatchable
 └── Veto
De recommendation engine kan daar vervolgens gewichten aan hangen.
Een ❤️ telt zwaarder dan een 👍.
Een favoriet geeft extra gewicht.
En een veto is gewoon een veto.
Geen enkel algoritme mag besluiten dat Costa! misschien tóch een goed idee is als ik expliciet heb gezegd dat ik hem nooit meer wil zien.
Geen AI?
Voor de aanbevelingen voorlopig niet.
Dat vind ik misschien wel het interessantste technische besluit van dit project.
Het zou heel eenvoudig zijn om alle informatie naar een taalmodel te sturen en te vragen:
Geef vijf leuke films voor Martin en Roos.
Maar dan weet ik niet goed waarom het model die films kiest.
En nog belangrijker: ik kan het gedrag moeilijk testen.
Dus de kern is voorlopig deterministisch.
Ongeveer:
profielen
   ↓
persoonlijke voorkeuren
   ↓
gezamenlijke score
   ↓
harde veto's verwijderen
   ↓
al geziene films verwijderen
   ↓
beschikbaarheid controleren
   ↓
kandidaten rangschikken
AI kan later best een rol krijgen.
Bijvoorbeeld voor:
"We willen iets spannends, maar niet eng en vooral niet langer dan twee uur."
Of om een menselijke uitleg te maken waarom een film wordt voorgesteld.
Maar AI wordt niet de autoriteit die bepaalt welke film bovenaan staat.
Dat wil ik zelf kunnen begrijpen.
De eerste fout
De eerste werkende Filmavond-versie was technisch eigenlijk best aardig.
Ik selecteerde de kijkers.
Ik koos maximaal twee stemmingen.
Bijvoorbeeld:
☀️ Licht
😬 Spannend
💥 Actie
🧠 Slim
❤️ Warm
🌑 Donker
Pick a Flick haalde kandidaten op, controleerde de streamingdiensten, berekende de gezamenlijke smaakscore en presenteerde het resultaat.
Twintig films.
En toen keek ik naar het scherm en dacht:
Wacht even.
Ik heb een applicatie gebouwd omdat ik geen zin heb om door twintig films te scrollen.
En mijn oplossing is...
...een scherm waarop ik door twintig films kan scrollen.
Oeps.
Eén film tegelijk
Dat is nu versie 0.7.2 geworden.
Pick a Flick werkt tegenwoordig meer als een stapel kaarten.
Je krijgt één film te zien.
Daarbij staan de poster, speelduur, genres, een korte beschrijving, beschikbaarheid en vooral:
Waarom deze?
Vervolgens moet je een beslissing nemen:
🚫 Nooit
⏭️ Nu niet
🤔 Misschien
👍 Kanshebber
🎲 Verrassend, maar vooruit
🎬 Deze wordt het
Pas daarna verschijnt de volgende film.
Een Nooit voor een bepaalde groep wordt onthouden.
Nu niet betekent alleen dat hij vanavond afvalt.
Misschien, Kanshebber en Verrassend, maar vooruit gaan naar de shortlist.
Na vier kanshebbers stopt Pick a Flick.
Dan verschijnt:
Welke wordt het?
Met alleen de vier overgebleven films.
Dat voelt ineens veel meer als het oorspronkelijke idee.
Niet zoeken.
Kiezen.
De groep is niet hetzelfde als het individu
Daar kwam nog een interessant dataprobleem bij.
Stel dat ik met iemand anders een film kies.
Betekent dat automatisch dat wij die film allebei persoonlijk leuk vinden?
Nee.
Daarom maak ik onderscheid tussen de filmavond en persoonlijke smaak.
Een gezamenlijke keuze beïnvloedt het persoonlijke smaakprofiel niet.
Pas na de film krijgt iedere kijker afzonderlijk de vraag wat hij of zij ervan vond.
Martin   ❤️
Roos     😐
Ronja    👍
Dat zijn drie verschillende signalen.
Daarnaast kun je aangeven:
🔁 Nog eens kijken
🛑 Afgehaakt
En als we de geselecteerde film uiteindelijk helemaal niet hebben gekeken:
Toch niet gekeken
Dan wordt er bewust geen smaakdata opgeslagen.
Technisch bestaat een kijkbeurt daarom uit een WatchEvent met daaronder afzonderlijke WatchParticipants.
De groep keek dezelfde film.
De mening erover blijft persoonlijk.
Inmiddels versie 0.9
Daarna ben ik wat gaan spelen met verschillende manieren van ontdekken.
De huidige versie heeft vijf modes.
🎬 Gewoon filmavond
De normale recommender.
Smaak + stemming + speelduur + beschikbaarheid.
🎲 Verras ons
Hier mag de engine bewust wat verder buiten het bekende profiel zoeken.
Een recommender die alleen maar steeds beter voorspelt wat je al kent, wordt uiteindelijk ook saai.
💎 Pareltjes
Minder voor de hand liggende films die wel behoorlijk gewaardeerd worden.
Dus niet alleen de populairste twintig titels van het moment.
📼 Gemist uit mijn tijd
Deze gebruikt het geboortejaar uit de profielen.
Niet om te concluderen dat iemand uit 1976 blijkbaar verplicht van films uit de jaren tachtig moet houden.
Wel om films te vinden uit een periode waarin iemand ze waarschijnlijk tegengekomen had kunnen zijn.
Een soort:
Hoe heb ik deze eigenlijk ooit gemist?
🔁 Nog een keer
Deze is juist heel simpel.
Zoek alleen tussen films waarvan minimaal één aanwezige eerder heeft aangegeven:
Die wil ik nog wel eens zien.
Uiteraard moet de film nog steeds ergens beschikbaar zijn.
Niet nul films teruggeven
Een ander ding dat tijdens het testen opviel:
twee moods + een maximale speelduur kan een heel redelijke vraag van een gebruiker zijn, maar technisch een behoorlijk strenge query opleveren.
Het eerste gedrag was dan:
0 films gevonden
Correct.
Maar niet erg behulpzaam.
Daarom zit er nu een adaptive fallback in.
Pick a Flick probeert eerst de exacte vraag.
Levert dat te weinig op, dan kan bijvoorbeeld de maximale speelduur iets worden verruimd. Daarna kan een tweede mood minder zwaar worden behandeld.
Dat gebeurt nooit met harde regels.
Een veto blijft een veto.
En een film die we nergens kunnen kijken wordt niet ineens een kandidaat omdat de database anders leeg is.
Als Pick a Flick de zoekopdracht verruimt, vertelt de interface dat ook.
Ik wil liever een uitlegbaar systeem dan een systeem dat stiekem besluit mijn invoer te negeren.
Wat er nu staat
Op dit moment ziet de architectuur er ongeveer zo uit:
                    ┌─────────────┐
                    │   Profiles  │
                    └──────┬──────┘
                           │
                           ▼
                    ┌─────────────┐
                    │    Taste    │
                    │   scoring   │
                    └──────┬──────┘
                           │
TMDb ──► Catalog ──────────┤
                           │
Watch providers ───────────┤
                           ▼
                    ┌─────────────┐
                    │ Film Night  │
                    │ recommender │
                    └──────┬──────┘
                           │
                           ▼
                    ┌─────────────┐
                    │ Candidates  │
                    └──────┬──────┘
                           │
                           ▼
                    ┌─────────────┐
                    │ Watch event │
                    │ + feedback  │
                    └─────────────┘
Onder de motorkap is het nog steeds een modular monolith.
Dat klinkt tegenwoordig bijna ouderwets.
Maar voor één container op een mini-pc in mijn huis lijkt me dat eigenlijk een uitstekende architectuur.
Deployment
De ontwikkelstraat is inmiddels ook behoorlijk echt geworden.
Ik bouw lokaal.
code
 ↓
git commit
 ↓
GitHub
 ↓
Komodo
 ↓
Docker build
 ↓
homelab
Databasewijzigingen gaan via Alembic migrations.
Komodo bouwt bij een deployment een nieuwe image en start de applicatie opnieuw.
Verder heeft Pick a Flick een /health endpoint, Prometheus metrics en structured logging, zodat hij netjes tussen de rest van mijn homelab-applicaties past.
Het begint verdacht veel op softwareontwikkeling te lijken.
Op naar 1.0
Versie 0.9 draait nu thuis.
De belangrijkste test is voorlopig niet technisch.
Ik ga hem gewoon gebruiken.
Met name ook met mensen die niet precies weten hoe de applicatie gebouwd is en waarom bepaalde knoppen bestaan.
Als je zelf weken aan iets hebt gebouwd, is iedere interface namelijk volkomen logisch.
Dat zegt helemaal niets.
Voor versie 1.0 staat daarom vooral polish op de planning.
De frontend is nu Nederlands, terwijl code, comments en README Engels zijn. Dat is eigenlijk prima, maar als ik Pick a Flick openbaar wil maken moet de taal van de interface configureerbaar worden. Nederlands en Engels lijkt me voor de eerste versie voldoende.
Daarnaast moeten foutmeldingen en lege states beter, wil ik nog eens goed naar de mobiele interface kijken en moet ik de attribution rond TMDb en de beschikbaarheidsdata netjes nalopen.
Het project begon met:
"Kunnen we niet gewoon sneller een film kiezen?"
Inmiddels heb ik een recommendation engine, provider abstractions, database migrations, groepsvoorkeuren, persoonlijke smaakprofielen, adaptive discovery en een deployment pipeline.
Volkomen logisch dus.
Als je het wil proberen: Je vind het projectje op GitHub https://github.com/MartinZwolle/pick-a-flick
Built with Python, Docker and mild chaos.